8 Stardog-Alternativen 2026: Knowledge Graphs & KI im Vergleich
Zu den Stardog-Alternativen gehören d.AP, GraphDB, Neo4j, eccenca, TopQuadrant, Amazon Neptune, Denodo und TigerGraph. Welche Plattform passt, hängt von ihrer Aufgabe ab: Soll sie KI-Agenten mit Unternehmenswissen versorgen, Ontologien verwalten, verteilte Daten abfragen oder Beziehungen mit Graphalgorithmen analysieren?

Knowledge Graphs (Wissensgraphen) bilden Entitäten und ihre Beziehungen ab. Für KI-Agenten zählt, welcher fachliche Kontext bei einer konkreten Anfrage verfügbar ist. Erkennt der Agent die relevanten Begriffe? Folgt er den richtigen Beziehungen? Ruft er aktuelle Fakten ab und hält dabei Zugriffsrechte ein? Ein großer Knowledge Graph allein beantwortet diese Fragen nicht.
Dieser Vergleich ordnet acht Alternativen nach ihren Schwerpunkten ein. Er erläutert Unterschiede zu Stardog, Auswahlkriterien und Anforderungen an eine Migration. Einige Plattformen überschneiden sich unmittelbar mit Stardog. Andere ersetzen nur einzelne Funktionen oder erfordern eine andere Architektur.
Zur Einordnung: Diesen Artikel veröffentlicht digetiers, der Anbieter von d.AP. Er dient der anforderungsbezogenen Auswahl und ist kein unabhängiges Leistungsranking. Die Angaben zu Wettbewerbern stützen sich auf die verlinkten Anbieterquellen. Der tatsächliche Funktionsumfang hängt von Produkt, Version, Lizenzpaket und Deployment ab.
Was ist Stardog?
Stardog ist eine semantische Plattform. Sie verbindet die Speicherung von Knowledge Graphs mit ontologiebasierter Modellierung, Inferenz und Datenvirtualisierung. Eine Ontologie legt die Fachbegriffe und ihre Zusammenhänge formal fest.
Die Inferenz-Engine von Stardog leitet aus deklariertem Wissen weitere Aussagen ab. Virtuelle Graphen machen externe Daten über Mappings als Graph abfragbar. Mappings beschreiben dabei, wie Quelldaten auf das gemeinsame Modell abgebildet werden. Quellen: Stardog-Plattform, Inference Engine, Virtual Graphs.
Stardog bietet auch Bedienoberflächen und KI-Funktionen. Mit Voicebox lassen sich Fragen in natürlicher Sprache stellen. Zum Funktionsumfang gehören generierte Abfragen und Einblicke in die Datengrundlage der Antworten. Designer unterstützt Modellierung und Mappings. Eine Beschreibung als reines Backend, für das grundsätzlich erst eine eigene Dialogoberfläche gebaut werden muss, wäre daher unzutreffend. Quellen: Voicebox, Designer.
Stardog kommt infrage, wenn ein Unternehmen gemeinsame Fachdefinitionen, semantische Integration, formale Inferenz oder graphgestützte KI benötigt. Eine Alternative lohnt sich, wenn sie besser zu den konkreten Abfragen, Zuständigkeiten, Betriebsbedingungen oder Integrationsanforderungen passt.
Für den Vergleich von KI-Kontext muss die gesamte Verarbeitung geprüft werden: die Fachfrage, der ausgewählte Kontext, die ausgeführte Abfrage und die zurückgegebene Antwort. Eine Ontologie oder eine Chatoberfläche ist dafür nur der Ausgangspunkt.
Stardog-Alternativen bewerten: Zehn Auswahlkriterien
Für Stardog und seine Alternativen sollten dieselben Fragen gelten. Ausgangspunkt ist die Aufgabe des Agenten. Danach folgt die Prüfung der Architektur.
- Kontext für die konkrete Anfrage: Wie wählt die Plattform relevante Begriffe, Beziehungen, Bedingungen und Fakten aus? Kann sie den Kontext erweitern, wenn eine Frage mehrere Fachbereiche betrifft? Zu prüfen sind fehlende und überflüssige Informationen.
- Explizite fachliche Bedeutung: Lassen sich Entitäten, Beziehungen und unternehmensspezifische Festlegungen einmal definieren und mehrfach nutzen? Welche Ontologiekonstrukte unterstützt die Plattform? Die Nennung desselben Standards belegt noch kein identisches Verhalten.
- Inferenz und korrekte Abfragen: Formale Inferenz bezeichnet die regelgeleitete Ableitung zusätzlicher Aussagen. Sie ist getrennt davon zu prüfen, wie ein Agent seinen Kontext verwendet. Weitere Prüfpunkte sind generierte Abfragen, der Umgang mit Mehrdeutigkeit und die Übereinstimmung der Antwort mit den abgerufenen Ergebnissen.
- Nachvollziehbarkeit und Belege: Lassen sich verwendeter Kontext, ausgeführte Abfrage und zugrunde liegende Ergebnisse einsehen? Sind der geltende Modellstand und der Zustand der Quellen bestimmbar? Eine vom Sprachmodell formulierte Erklärung reicht als Nachweis nicht aus.
- Bedienbarkeit und Expertenaufwand: Was können Fachexperten selbst pflegen? Wo werden Data Engineers, Ontologiespezialisten oder Entwickler benötigt? Zur Bewertung gehört auch der Aufwand, gemeinsame Fachdefinitionen zu vereinbaren.
- Anbindung von KI-Agenten: Welche Schnittstellen umfasst das gewählte Paket? Bleiben Identität und Berechtigungen beim Zugriff erhalten? Werden unstrukturierte Quellen benötigt, ist der Abruf von Dokumenteninhalten gesondert zu testen.
- Datenföderation und Aktualität: Welche Quellen werden direkt abgefragt, zwischengespeichert, synchronisiert oder materialisiert? Wie verknüpft die Plattform Daten aus mehreren Quellen? Kontext zur Laufzeit zusammenzustellen und aktuelle Quelldaten abzurufen sind unterschiedliche Fähigkeiten.
- Governance und produktiver Betrieb: Wer gibt Änderungen an Modellen, Mappings und Regeln frei? Wo werden Zugriffsrechte durchgesetzt? Darf ein Agent Aktionen auslösen, muss feststehen, wer diese vor einer Änderung im Quellsystem validiert.
- Deployment und Skalierbarkeit: Zu prüfen sind Betriebsmodell, Datenstandort, gleichzeitige Anfragen, Wiederherstellung und Betriebsverantwortung. Datenmenge, Ontologiegröße und strukturelle Komplexität brauchen getrennte Messungen.
- Einführungsaufwand, Gesamtkosten und Anbieterwechsel: Die Kalkulation muss Modellierung, Integration, Infrastruktur, Lizenzen, Modellnutzung, Betrieb und Migration enthalten. Ein Exporttest sollte zeigen, ob sich die Wissensmodelle außerhalb der ursprünglichen Laufzeitumgebung weiterverwenden lassen.
Welche Plattform gehört in die engere Auswahl?
- Ontologiegestützter Kontext für KI-Agenten: d.AP zusammen mit Stardog und weiteren semantischen Plattformen mit Agentenfunktionen prüfen.
- RDF-Datenbank mit definierten Inferenzregeln: Stardog und GraphDB anhand der tatsächlich benötigten Regeln und Abfragen vergleichen.
- Property-Graph-Anwendungen oder Graphalgorithmen: Neo4j und TigerGraph prüfen. Den Aufwand für die Übertragung bestehender RDF-Semantik einrechnen.
- Unternehmensweite Wissensmodellierung und Governance: eccenca und TopQuadrant bewerten. Dazu gehört der Weg vom freigegebenen Modell bis zur nutzenden Anwendung.
- Verwaltete RDF-Datenhaltung auf AWS: Neptune Database prüfen und die zusätzlich benötigten Dienste berücksichtigen.
- Logischer Zugriff auf verteilte operative Daten: Denodo und Stardog anhand repräsentativer Verknüpfungen, Aktualitätsanforderungen und Zugriffsregeln vergleichen.
Vergleichstabelle: Stardog und acht Alternativen
Die Tabelle zeigt architektonische Schwerpunkte. Sie vergibt keine ungemessenen Leistungsnoten. Produktquellen und Einschränkungen stehen in den Anbieterprofilen; die Angaben zu Stardog sind oben belegt.
| Plattform | Schwerpunkt | Zu prüfender Ansatz | Entscheidende Frage |
|---|---|---|---|
| Stardog als Referenz | Semantische Integration und graphgestützte KI | Inferenz, virtuelle Graphen und Voicebox | Liefert die gewählte Konfiguration vollständigen und korrekten Kontext für die Fachfragen? |
| d.AP | Explizites Unternehmenswissen für Agenten | Schema-Anker, strukturelle Kontexterweiterung und ontologiegestützte Agentenarbeit | Bewährt sich die gezielte Kontextauswahl auch bei großen und komplexen Wissensmodellen? |
| GraphDB | RDF-Datenmanagement und Inferenz | Regelbasierte Inferenz sowie Graph- und KI-Werkzeuge | Erfüllen das gewählte Regelwerk und die Kontextverarbeitung die Anforderungen? |
| Neo4j | Property-Graph-Anwendungen und Analysen | Cypher-Abfragen und KI mit Graphkontext | Bleibt die benötigte fachliche Bedeutung im Property-Graph-Modell erhalten? |
| eccenca | Semantische Datenintegration im Unternehmen | Gepflegte Wissensmodelle, Mappings und Bereitstellungsprozesse | Wie viel Expertenarbeit erfordern Aufbau und Pflege wiederverwendbaren Kontexts? |
| TopQuadrant | Semantische Governance und freigegebener Kontext | Verwaltete Ontologien und Kontextbereitstellung im gewählten Angebot | Erreichen freigegebene Definitionen die Agenten mit den benötigten Rechten und Aktualisierungen? |
| Neptune Database | Verwaltete Graphdatenhaltung auf AWS | RDF/SPARQL mit separat gewählten KI- und Semantikkomponenten | Welche Stardog-Funktionen müssen andere Komponenten übernehmen? |
| Denodo | Logischer Datenzugriff und Datenvirtualisierung | Semantische Abstraktion und KI-Zugriff auf verbundene Quellen | Passen Abfrageausführung und semantische Ausdrucksmöglichkeiten zum Agenten? |
| TigerGraph | Graphalgorithmen und Anwendungen auf vernetzten Daten | GSQL, Graphanalysen und KI-Anbindungen | Rechtfertigen gemessene Vorteile den Modellierungs- und Migrationsaufwand? |
Die acht Stardog-Alternativen im Detail
„Geeignet“ bedeutet hier: passend zu einer definierten Anforderung. Die Reihenfolge ist kein Benchmark-Ranking.
1. d.AP von digetiers: Ontologiegestützter Kontext für KI-Agenten
Geeignet für: Unternehmen, die prüfen möchten, wie explizites Fachwissen Agenten durch große oder komplexe Unternehmensmodelle führen kann.

Eine KI-Kontextplattform stellt Agenten das Unternehmenswissen bereit, das sie für ihre jeweilige Aufgabe benötigen. d.AP verfolgt dafür den Ansatz einer expliziten Wissensschicht. Eine formale Ontologie beschreibt Fachbegriffe und Beziehungen. Fachliche Festlegungen sollen dadurch gemeinsam nutzbar werden, statt in jeder Anwendung erneut erschlossen zu werden.
Wie d.AP den Kontext zusammenstellt
Im Mittelpunkt steht die gezielte Kontextzusammenstellung, technisch auch Selective Context Assembly genannt. d.AP identifiziert per Ähnlichkeitssuche relevante Elemente des Schemas als Ankerpunkte. Anschließend erweitert die Plattform den Ausschnitt entlang der deklarierten Ontologiestruktur. Diese strukturelle Erweiterung erfolgt deterministisch. Benötigt der Agent weiteren Kontext, kann er die Nachbarschaft entlang deklarierter Beziehungen untersuchen.
Der Ansatz soll ein Skalierungsproblem lösen: Ein Agent sollte nicht für jede Frage die gesamte Unternehmensontologie erhalten müssen. Ein kleinerer Ausschnitt garantiert allerdings nicht, dass er sämtliche benötigten Begriffe enthält. Auch macht ein deterministischer Erweiterungsschritt den gesamten Ablauf mit einem Sprachmodell weder deterministisch noch fehlerfrei.
Zum Entwicklungsstand: Nach Angaben von digetiers sind diese Kontextmechanismen implementiert. Der Artikel belegt keine unabhängig gemessene Überlegenheit gegenüber Stardog. Ihre Eignung ist mit repräsentativen Fragen und Modellen im vorgesehenen Deployment zu prüfen.
Gemeinsamkeiten mit Stardog
- Beide Ansätze nutzen explizite semantische Modelle für die Arbeit mit Unternehmenswissen.
- Beide kommen für graphgestützte KI infrage.
- Beide benötigen korrekte Quellzuordnungen und gepflegte Fachdefinitionen. Die Abstimmung zwischen Fachbereichen bleibt Expertenarbeit.
Stardog vs. d.AP: Der relevante Unterschied
Der Vergleich betrifft die Mechanismen der Wissensnutzung. Bei d.AP steht im Mittelpunkt, wie die Ontologiestruktur die Kontextzusammenstellung und die Arbeit des Agenten führt. Stardog dokumentiert sowohl eine Inferenz-Engine als auch Abläufe in Voicebox. Diese Fähigkeiten müssen getrennt bewertet werden. Quellen: Stardog Inference Engine, Voicebox.
d.AP sieht ein eingeschränktes OWL-Profil als deklarierte Struktur vor. Der Ansatz wird hier weder als vollständiger OWL-2-DL-Reasoner noch als Ersatz für jede Inferenzfunktion von Stardog zur Abfragezeit dargestellt.
Produkt und Methodik für gemeinsame Fachdefinitionen
d.AP verbindet den Produktansatz mit einer Methodik zur Definition fachlicher Bedeutung. Die Architektur trennt das Wissensmodell von den Quellsystemen, die operative Fakten führen. Fachbereichsmodelle sollen explizite Identifikatoren und Beziehungen gemeinsam nutzen. So sollen konkurrierende Definitionen in den angebundenen Anwendungen vermieden werden.
Ein Beispiel: „Kunde“ kann in einem System die vertragschließende juristische Person bezeichnen, in einem anderen ein Benutzerkonto. Diese Unterscheidung muss ausdrücklich modelliert werden. Danach ist zu klären, welche Bedeutung eine Frage meint. Eine Verbindung im Graphen allein löst die Mehrdeutigkeit nicht auf.
Portabilität als Gestaltungsprinzip
Die Verfügung des Kunden über sein formalisiertes Unternehmenswissen ist ein Gestaltungsprinzip von d.AP. Zu diesem Wissen gehören Modelle sowie die Mappings, Regeln und Abfragen, die für ihre Nutzung erforderlich sind.
Portabilität muss dennoch an der konkreten Implementierung geprüft werden. Eine Ontologie zu exportieren ist etwas anderes, als ihr Verhalten in einem anderen System zu reproduzieren. Laufzeitumgebung, Agentenimplementierung und Bearbeitungswerkzeuge sind von den Wissensmodellen zu unterscheiden. Ihre Übertragbarkeit darf nicht vorausgesetzt werden.
Auch Stardog und andere standardbasierte Plattformen unterstützen offene semantische Formate. Der Vergleich muss deshalb die tatsächliche Wiederverwendung testen. Offenheit ist kein ausschließliches Merkmal von d.AP.
Nachvollziehbare Antworten als Abnahmekriterium
Für eine d.AP-Evaluation sollte eine nachvollziehbare Belegkette verlangt werden: von der Antwort über den verwendeten Kontext und die ausgeführte Abfrage bis zu den zugrunde liegenden Ergebnissen. Falls frühere Antworten rekonstruierbar sein müssen, gehören die geltenden Modell- und Mappingstände dazu.
Diese Fähigkeit ist im vorgesehenen Deployment nachzuweisen. Die Nutzung einer Ontologie belegt für sich genommen weder die vollständige Herkunft jeder Aussage noch die Korrektheit jeder generierten Abfrage.
Wann d.AP statt Stardog wählen? Wenn eine repräsentative Evaluation zeigt, dass der ontologiegestützte Kontextansatz die Anforderungen besser erfüllt. Besonders relevant sind große Wissensmodelle und fachbereichsübergreifende Fragen. Zu messen sind Kontextvollständigkeit, Abfragekorrektheit, Latenz, Pflegeaufwand und Kosten je korrekter Antwort. Muss ein bestehendes Inferenzverhalten erhalten bleiben, ist dessen Kompatibilität vor der Auswahl gesondert nachzuweisen.
Anbieter: digetiers
2. GraphDB: RDF-Datenbank mit regelbasierter Inferenz
Geeignet für: Teams, die RDF-Datenmanagement, SPARQL und eine definierte Konfiguration für regelbasierte Inferenz benötigen.
GraphDB verbindet eine RDF-Datenbank mit Inferenz- und Verwaltungswerkzeugen. Das aktuelle Angebot umfasst auch KI-Funktionen und Anbindungen. Eine Einordnung als Datenbank ohne Bedienoberfläche oder KI-Unterstützung wäre daher zu eng. Quelle: GraphDB-Produktübersicht.
Gemeinsamkeiten mit Stardog: RDF/SPARQL, semantische Modelle, Inferenz und Werkzeuge für Unternehmensgraphen.
Wesentliche Unterschiede: GraphDB dokumentiert Vorwärtsverkettung, auch Forward Chaining genannt, mit unterstützten Regelwerken. Stardog beschreibt einen Ansatz, der Abfragen anhand des Schemas erweitert und Inferenz zur Abfragezeit ausführt. Zu vergleichen sind die unterstützte Semantik, das Verhalten bei Aktualisierungen, die Abfrageergebnisse und die Betriebskosten. Die GraphDB-Komponente ist außerdem von zusätzlichen Funktionen der Graphwise-Plattform zu unterscheiden. Quellen: GraphDB, Stardog Inference Engine.
Wann GraphDB statt Stardog wählen? Wenn die gewählte GraphDB-Konfiguration besser zu den benötigten Ableitungen, RDF-Abfragen, Werkzeugen und Betriebsbedingungen passt. Geht es vorrangig um KI-Kontext, muss der gesamte Agentenablauf getestet werden. Seine Qualität lässt sich nicht aus Datenbankfunktionen allein ableiten.
Anbieter: GraphDB
3. Neo4j: Property Graphs, Graphanalysen und KI-Anwendungen
Geeignet für: Teams, die Property-Graph-Anwendungen, Beziehungsanalysen und graphgestützte KI auf Basis von Cypher entwickeln.
Neo4j bietet Graphdatenbanken, Analysewerkzeuge und Agentenfunktionen. Das Property-Graph-Modell unterscheidet sich architektonisch von Stardogs RDF-Ansatz. Der Vergleich lautet daher nicht „moderne KI-Plattform gegen traditionelle semantische Datenbank“. Quelle: Neo4j-Produkte.
Gemeinsamkeiten mit Stardog: Abfragen vernetzter Daten, grafische Erkundung und Unterstützung für KI-Anwendungen mit Graphkontext.
Wesentliche Unterschiede: Das Property-Graph-Modell und die Abfragesprache Cypher bestimmen, wie Wissen dargestellt und abgefragt wird. Bestehende RDF-Ontologien, logische Ableitungen und SPARQL-Abfragen benötigen eine bewusste Kompatibilitäts- oder Übersetzungsstrategie. Ein identisches Verhalten nach der Umwandlung darf nicht vorausgesetzt werden.
Wann Neo4j statt Stardog wählen? Wenn eine Property-Graph-Anwendung und ihr Ökosystem besser zu den Anforderungen passen. Die benötigte Semantik muss sich dabei umsetzen und dauerhaft pflegen lassen. Leistung sollte anhand repräsentativer Abfragen gemessen werden. Keines der beiden Graphmodelle ist pauschal schneller.
Anbieter: Neo4j
4. eccenca Corporate Memory: Semantische Integration und Governance
Geeignet für: Unternehmen, die semantische Datenintegration mit Wissensmodellierung und geregelten Pflegeprozessen verbinden möchten.
Corporate Memory unterstützt Wissensmodelle, Datenintegration, visuelle Mappings und kontrollierten Zugriff auf Unternehmenswissen. Der Einsatzbereich reicht über einzelne Branchen oder Lieferkettenanwendungen hinaus. Quelle: eccenca Corporate Memory.
Gemeinsamkeiten mit Stardog: Standardbasierte Knowledge Graphs im Unternehmen, ontologiebasierte Integration und wiederverwendbarer semantischer Datenzugriff.
Wesentliche Unterschiede: Modellierung, Mappings, Governance und Wissensbereitstellung sollten als zusammenhängender Arbeitsablauf bewertet werden. Entscheidend ist, wie Fachexperten und technische Teams zusammenarbeiten. Ebenso wichtig ist, wie sie das gepflegte Wissen anschließend Anwendungen und Agenten bereitstellen.
Wann eccenca statt Stardog wählen? Wenn der integrierte Modellierungs- und Governance-Prozess besser zu den Zuständigkeiten und Umsetzungsanforderungen passt. Die Kontextbereitstellung zur Laufzeit sollte mit der vorgesehenen Agentenarchitektur demonstriert werden. Ein gepflegter Graph allein belegt diese Fähigkeit nicht.
Anbieter: eccenca Corporate Memory
5. TopBraid EDG / TopQuadrant: Ontologien und freigegebenes Wissen
Geeignet für: Teams, deren Schwerpunkt auf Ontologien, Taxonomien, Referenzdaten und gemeinsam gepflegten Fachdefinitionen liegt.
TopBraid EDG steht für semantische Data Governance und Wissensmodellierung. Das aktuelle Angebot TQ Data Foundation beschreibt außerdem die Bereitstellung freigegebenen, maßgeblichen Kontexts für Agenten. Für einen Vergleich müssen das konkrete Produkt und das angebotene Paket feststehen. Eine ältere Einordnung als reines Taxonomiewerkzeug wird dem Gesamtangebot nicht gerecht. Quellen: EDG-Dokumentation, TQ Data Foundation.
Gemeinsamkeiten mit Stardog: Explizite semantische Modelle, offene Standards zur Wissensrepräsentation und Integration von Unternehmenswissen.
Wesentliche Unterschiede: TopQuadrant legt besonderes Gewicht darauf, wie Experten maßgebliche Definitionen erstellen, freigeben und pflegen. Das aktuelle Angebot beschreibt auch Agentenschnittstellen. Sowohl die Governance-Funktionen als auch die Bereitstellung zur Laufzeit müssen im gewählten Paket nachgewiesen werden. Quelle: TQ Data Foundation.
Wann TopQuadrant statt Stardog wählen? Wenn die geregelte Pflege und Veröffentlichung gemeinsamer Wissensmodelle die Hauptanforderung ist und die vorgeschlagene Konfiguration die nötigen Zugriffsmuster unterstützt. Zur Bewertung gehören typische Aufgaben der fachlich Verantwortlichen. Eine pauschale Aussage über die „beste Oberfläche“ ersetzt diese Prüfung nicht.
Anbieter: TopQuadrant
6. Amazon Neptune Database: Verwaltete RDF-Datenhaltung auf AWS
Geeignet für: Unternehmen, die RDF/SPARQL innerhalb einer AWS-Architektur als verwalteten Datenbankdienst nutzen möchten.
Neptune Database unterstützt RDF/SPARQL und Property-Graph-Anwendungen. AWS übernimmt betriebliche Aufgaben wie Backups und stellt Verfügbarkeitsfunktionen bereit. Neptune Analytics und weitere KI-Dienste von AWS sind separate Komponenten. Ihre Funktionen dürfen nicht automatisch der RDF-Datenbank zugerechnet werden. Quelle: Amazon Neptune FAQ.
Gemeinsamkeiten mit Stardog: Speicherung und Abfrage vernetzter Daten, einschließlich RDF-Zugriff über SPARQL.
Wesentliche Unterschiede: Neptune Database ist ein verwalteter Graphdatenbankdienst. Soll eine umfangreichere Stardog-Implementierung ersetzt werden, müssen Ontologiewerkzeuge, Inferenz, Föderation, Agentenkontext und Governance gesondert berücksichtigt werden. SPARQL-Unterstützung allein bedeutet keine Funktionsgleichheit.
Wann Neptune statt Stardog wählen? Wenn AWS-Integration und verwalteter Datenbankbetrieb Priorität haben und die übrige Architektur die fehlenden Aufgaben abdeckt. Für die Kostenbewertung zählen die gesamte Lösung, angebundene Dienste und Entwicklungsaufwand. Verwaltete Datenhaltung garantiert keine niedrigeren Gesamtkosten.
Anbieter: Amazon Neptune
7. Denodo: Datenvirtualisierung und Zugriff auf verteilte Quellen
Geeignet für: Unternehmen, die einen gemeinsamen logischen Zugriff auf heterogene Datenquellen und deren föderierte Abfrage benötigen.
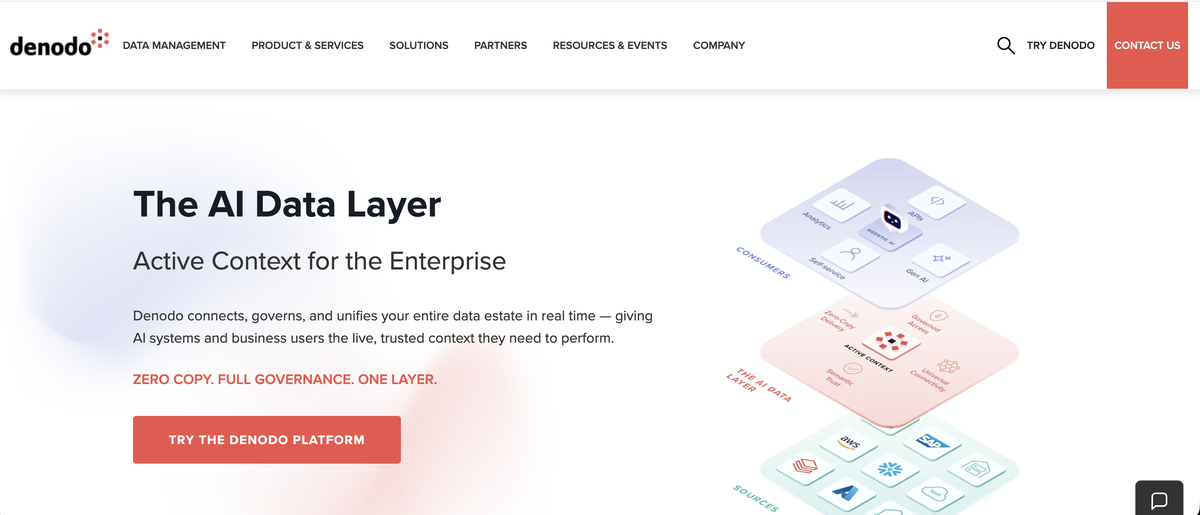
Denodo verbindet Datenvirtualisierung mit semantischen Funktionen, Governance und KI-Anbindungen. Die aktuelle Positionierung umfasst eine Datenschicht, die Kontext für KI bereitstellt. Eine Beschreibung als „nur SQL“ oder „ohne Semantik“ wäre unzutreffend. Quelle: Denodo-Plattform.
Gemeinsamkeiten mit Stardog: Beide schaffen eine Abstraktion über verteilten Daten. Sie verbinden Quellen und unterstützen fachlich ausgerichtete Zugriffe, ohne sämtliche Anwendungen auf einen einzigen physischen Speicher festzulegen.
Wesentliche Unterschiede: Zu prüfen sind die darstellbare Semantik, die Ausführung quellenübergreifender Abfragen und der Weg des Kontexts zum Agenten. Eine logische semantische Schicht ist nicht automatisch einem ontologiebasierten Inferenzsystem gleichzusetzen. Denodo unterstützt auch Caching und selektive Materialisierung. „Keine Datenbewegung“ ist deshalb keine allgemeingültige Eigenschaft jedes Deployments. Quelle: Denodo-Plattform.
Wann Denodo statt Stardog wählen? Wenn der kontrollierte Zugriff auf verteilte operative Daten die Hauptaufgabe ist und Denodos Ausführungsmodell die Anforderungen erfüllt. Hängt die Anwendung von formaler Modellierung oder bestimmten Inferenzen ab, müssen diese gesondert geprüft werden.
Anbieter: Denodo
8. TigerGraph: Graphalgorithmen und Analysen vernetzter Daten
Geeignet für: Teams, deren Anwendungen Graphalgorithmen und GSQL-basierte Verarbeitung vernetzter Daten benötigen.
TigerGraph bietet eine Graphdatenbank, Analysefunktionen, visuelle Entwicklungswerkzeuge und KI-Funktionen. Das Angebot reicht über eine reine Datenbank-Engine für technische Nutzer hinaus. Quelle: TigerGraph-Produktübersicht.
Gemeinsamkeiten mit Stardog: Anwendungen auf vernetzten Daten, Graphabfragen und graphgestützte KI-Anwendungsfälle.
Wesentliche Unterschiede: Graphmodell, GSQL und algorithmische Verarbeitung unterscheiden sich von einem RDF/SPARQL-Ansatz mit ontologiebasierter Inferenz. Bei einer Migration muss daher die fachliche Bedeutung des bestehenden Modells geprüft werden. Knoten und Kanten zu übertragen reicht nicht aus.
Wann TigerGraph statt Stardog wählen? Wenn repräsentative Tests zeigen, dass Graphalgorithmen und Anwendungsmodell die Anforderungen besser erfüllen. Bei Betrugserkennung, Abhängigkeitsanalysen oder Netzwerkanalysen zählt die konkrete Verarbeitung. Eine hohe Datenmenge allein begründet keine Plattformwahl.
Anbieter: TigerGraph
Welche Stardog-Alternative passt zu welchem Anwendungsfall?
Semantisches Datenmanagement mit RDF und SPARQL
Ausgangspunkt: Stardog und GraphDB. eccenca ergänzt die Auswahl, wenn integrierte Modellierung und Governance wichtig sind.
Für RDF-Anwendungen zählen unterstützte Ontologieprofile, Inferenzverhalten, Aktualisierungskosten und SPARQL-Ergebnisse. Steht verwaltete Datenhaltung auf AWS im Vordergrund, kommt Neptune Database hinzu. Semantische Funktionen, die andere Komponenten übernehmen müssen, gehören in die Bewertung.
Knowledge Graphs und Ontologien für KI-Agenten
Ausgangspunkt: d.AP und Stardog. Graphwise, eccenca und TopQuadrant sind anhand des benötigten Pakets und Arbeitsablaufs ebenfalls zu prüfen.
Geeignete Testfragen überschreiten Fachbereichsgrenzen und enthalten mehrdeutige Begriffe. Die Plattform muss den benötigten Ontologiekontext auswählen, die richtigen Fakten abrufen und bei Bedarf nachfragen.
Hier ist ein Vergleich Stardog vs. d.AP besonders relevant. Bei großen Wissensmodellen sollten Kontextauswahl und Antwortkorrektheit getrennt von der Speicherkapazität des Graphen gemessen werden. Falls Dokumente zum benötigten Kontext gehören, ist ihr Abruf ein eigener Testfall.
Datenföderation und Datenvirtualisierung
Ausgangspunkt: Stardog und Denodo. Weitere Kandidaten sind anhand der tatsächlichen Quellsysteme zu bewerten.
Zu vergleichen sind unterstützte Quellen, Mappings, quellenübergreifende Verknüpfungen, Caching und die Durchsetzung von Richtlinien. Hinzu kommt Query Pushdown: Welche Teile einer Abfrage kann bereits das Quellsystem ausführen?
Ein Konnektor und eine Föderations-Engine beschreiben verschiedene Teile der Architektur. Ihre Existenz sagt noch nicht, wo und wie eine verteilte Abfrage ausgeführt wird.
Für d.AP müssen die benötigten Quellzugriffsarten und die erwartete Datenaktualität ausdrücklich festgelegt werden. Aus der Kontextzusammenstellung lassen sie sich nicht ableiten.
Governance, Taxonomien und gemeinsame Fachbegriffe
Ausgangspunkt: TopQuadrant und eccenca. Andere Plattformen bleiben relevant, wenn ihre Pflege- und Freigabeprozesse die Anforderungen erfüllen.
Fachexperten sollten im Test einen Begriff vorschlagen, einen Definitionskonflikt lösen und eine Änderung freigeben. Danach prüfen sie deren Wirkung auf angebundene Anwendungen. Das Ergebnis muss zeigen, wer die Definition verantwortet und wie die freigegebene Fassung ihre Nutzer erreicht.
Migration: Stardog ersetzen oder ergänzen?
Eine Alternative kann die Datenbank, semantische Werkzeuge, die Kontextbereitstellung für Agenten oder mehrere dieser Schichten ersetzen. Vor der Migrationsplanung muss daher feststehen, welche Verantwortung wechselt.
Vollständige Ablösung und paralleler Betrieb sind beide mögliche Architekturen. Keiner der Wege ist grundsätzlich häufiger oder sicherer. Die Entscheidung hängt von der bestehenden Implementierung, der Zielplattform und den Ergebnissen eines Piloten ab.
Stardog vollständig ablösen
Eine vollständige Ablösung kommt infrage, wenn die Zielarchitektur die benötigten Funktionen erfüllt und der Nutzen Kosten und Risiken rechtfertigt. Gründe können Betriebsanforderungen, Vertragsbedingungen, die Eignung für Anwendungen oder die Kontextbereitstellung sein.
Dabei geht es nicht um eine Wahl zwischen fachlich richtigen Antworten und semantischer Korrektheit. Fachlich richtige Antworten setzen voraus, dass die Bedeutung der Informationen erhalten bleibt.
Stardog-Migration in sechs Schritten
- Bestand erfassen: Ontologien, Instanzdaten, benannte Graphen, Mappings, Regeln, Abfragen, Quellverbindungen, Zugriffsrechte und angebundene Anwendungen dokumentieren. Abhängigkeiten von bestimmten Inferenzeinstellungen oder Erweiterungen gesondert markieren.
- Export und Kompatibilität prüfen: Stardog verwendet bereits RDF-basierte Standards. Die Aufgabe besteht darin, Identifikatoren und Bedeutung zu erhalten und die unterstützten Profile der Zielplattform zu prüfen.
- Kompatible Mappings wiederverwenden: Stardog unterstützt R2RML und SMS2. Die Werkzeuge können Mappings in unterstützten Fällen übersetzen. Erweiterte Ausdrücke und nichtrelationale Mappings benötigen eine separate Prüfung. Weder ein vollständiger Neubau noch eine verlustfreie Konvertierung sämtlicher Mappings sollte pauschal angenommen werden. Quellen: Virtual Graphs, Tutorial zu Virtual-Graph-Mappings.
- Gleichwertiges Verhalten testen: Referenzabfragen, erwartete logische Ableitungen, Validierungsbedingungen, Zugriffsbeschränkungen und typische Agentenantworten vergleichen. Ein erfolgreicher Import belegt keine semantische Gleichwertigkeit.
- Mit einem Fachbereich oder Arbeitsablauf beginnen: Beide Lösungen parallel betreiben, Unterschiede messen und einen Rückweg offenhalten. Nutzende Anwendungen nur dann zuerst umstellen, wenn Schnittstellen und Berechtigungen nachgewiesen funktionieren.
- Die bisherige Komponente nach Abnahme stilllegen: Vorher Betriebsverantwortung, Wiederherstellung und Abhängigkeiten nachgelagerter Systeme klären.
Stardog durch eine weitere Komponente ergänzen
Ein paralleler Betrieb kann sinnvoll sein, wenn Stardog benötigte Aufgaben bereits erfüllt und eine weitere Komponente einen nachgewiesenen Zusatznutzen bringt. Beispielsweise kann ein Team bestehende Graphdienste beibehalten und für einen Agenten eine andere Kontextverarbeitung testen.
Die Integration muss Modellinterpretation, Authentifizierung, Berechtigungen und Datenaktualität erhalten. Ein vorhandener SPARQL-Endpunkt allein belegt noch keine problemlose Zusammenarbeit zweier Plattformen.
Eine Kombination aus d.AP und Stardog ist daher eine zu prüfende Architekturoption. Dieser Artikel verspricht keine bereits verifizierte Standardintegration. Ebenso wenig setzt er voraus, dass eine der beiden Plattformen große Modelle grundsätzlich besser bewältigt.
Beispiel: Lieferantenzertifikate und offene Aufträge
Ein hypothetischer Hersteller möchte wissen:
Welche offenen Aufträge hängen von Lieferanten ab, deren aktuelle Zertifizierung vor dem geplanten Versand abläuft?
Der Pilot muss die Bedeutung von Lieferant, Zertifikatsgültigkeit, Auftragsstatus und Versanddatum verbinden. Außerdem muss feststehen, wie fehlende Zertifikate und mehrere Teillieferungen behandelt werden.
Der Test beginnt mit einem begrenzten fachlichen Ausschnitt und vorab geprüften Referenzantworten. Bestehende Quell- und Graphdienste bleiben währenddessen erhalten, sofern die Schnittstellen das erlauben. Anschließend werden der bisherige und der vorgeschlagene Agentenablauf verglichen.
Zu prüfen ist, welche Begriffe ausgewählt, welche Daten verknüpft und welche Datumsbedingungen angewandt wurden. Aufträge ohne Zugriffsberechtigung dürfen nicht in der Antwort erscheinen. Erst nach der Abnahme des Antwortverhaltens und der Betriebszuständigkeiten wird der Umfang erweitert.
Ontologien und fachliche Bedeutung bei der Migration erhalten
Ziel einer Migration ist weiter nutzbares Unternehmenswissen. Eine exportierte Graphdatei allein genügt dafür nicht.
Typische technische Risiken
Zu prüfen sind verlorene Identifikatoren, veränderte Inferenzannahmen und ein anderer Umgang mit Nullwerten oder fehlenden Angaben. Ebenso wichtig sind Änderungen daran, wie Datensätze aus Quellsystemen zu Graphentitäten werden.
Eine Abfrage kann technisch weiterhin funktionieren und dennoch ein anderes fachliches Ergebnis liefern. Diese Punkte sind Migrationsrisiken, keine pauschalen Vorwürfe gegen einen bestimmten Anbieter.
Woran sich eine erfolgreiche Übertragung erkennen lässt
Die Zielplattform erhält oder übersetzt die relevanten Definitionen und Beziehungen ausdrücklich. Wiederverwendete Mappings erzeugen die vorgesehenen Entitäten. Benötigte Regeln und Validierungsbedingungen greifen weiterhin. Referenzabfragen und Berechtigungstests liefern die vereinbarten Ergebnisse.
Bei einer Migration von RDF zu einem Property Graph muss die semantische Übersetzung dokumentiert werden. Auch bei RDF-zu-RDF-Migrationen sind Profile, Funktionen, Inferenzeinstellungen und betriebliche Erweiterungen zu prüfen.
Fachliche Verantwortung und Governance sichern
Ein Plattformwechsel kann Zuständigkeiten offenlassen, obwohl die technische Migration gelingt. Es muss feststehen, wer Definitionen freigibt, Mappings pflegt, fachbereichsübergreifende Konflikte löst und Regeländerungen genehmigt.
Dazu gehören sechs Fragen:
- Welches Team verantwortet eine Fachdefinition und ihren Identifikator?
- Welche Wissensartefakte lassen sich exportieren, welche benötigen die ursprüngliche Laufzeitumgebung?
- Wer gibt Modelländerungen frei, bevor Agenten sie verwenden?
- Wie bleiben Zugriffsrechte der Quelldaten in der Kontextschicht erhalten?
- Wie weit muss eine frühere Antwort rekonstruierbar sein?
- Wer validiert eine vom Agenten ausgelöste Aktion, bevor sich ein Quellsystem ändert?
Häufige Fehlermuster sind auseinanderlaufende Kopien derselben Definition, Berechtigungsprüfungen nur in der Oberfläche und Fachlogik in undokumentierten Prompts oder Anwendungscode. Ein weiteres Risiko entsteht, wenn zwar der Export getestet wird, nicht aber die Nutzung in einem zweiten System.
Die Konsequenz: Verantwortliche für Wissensmodelle benennen und die Artefakte versionieren, die das vereinbarte Verhalten bestimmen. Referenzfragen und erwartete Ergebnisse dauerhaft pflegen. Vor einer größeren Bindung einen kleinen Export mit anschließender Wiederverwendung testen. Fachexperten an Änderungen beteiligen, die Bedeutung verändern.
Häufige Fragen zu Stardog-Alternativen
Welche Stardog-Alternative eignet sich für KI im Unternehmen?
Die passende Alternative hängt von der Aufgabe ab. d.AP kommt für explizites Unternehmenswissen und ontologiegestützten KI-Kontext infrage. GraphDB ist ein Kandidat für RDF-Datenhaltung und regelbasierte Inferenz. eccenca und TopQuadrant eignen sich zur Prüfung von Wissensmodellierung und Governance. Neo4j und TigerGraph sind Kandidaten für Property-Graph-Anwendungen und Graphanalysen.
Alle Kandidaten sollten dieselben Fachfragen, Quelldaten und Abnahmekriterien durchlaufen. Die Anbieterprofile erläutern ihre Schwerpunkte und verlinken die jeweilige Dokumentation.
Wie unterscheidet sich d.AP von Stardog?
d.AP legt den Schwerpunkt darauf, gemeinsame fachliche Bedeutung für Agenten nutzbar zu machen. Der Kontextansatz identifiziert relevante Schema-Anker und erweitert den Ausschnitt über deklarierte Ontologiebeziehungen. Der Agent kann diese Beziehungen für weitere Erkundungen nutzen. Die beschriebenen Kontextmechanismen sind nach Angaben von digetiers implementiert; eine unabhängig gemessene Überlegenheit wird hier nicht behauptet.
Stardog verbindet semantische Datenhaltung, Inferenz, virtuelle Graphen und natürlichsprachlichen Zugriff über Voicebox. Zu vergleichen ist, wie beide Plattformen eine Fachfrage in nutzbaren Kontext überführen. d.AP sieht dafür ein eingeschränktes OWL-Profil vor. Anwendungen, die vom Inferenzverhalten von Stardog abhängen, benötigen eine separate Kompatibilitätsprüfung. Quellen: Inference Engine, Virtual Graphs, Voicebox.
Welche Stardog-Alternativen unterstützen RDF, OWL und SPARQL?
GraphDB ist ein direkter Kandidat für RDF/SPARQL mit OWL-bezogener Inferenz über unterstützte Regelwerke. d.AP sieht RDF, ein OWL-basiertes Fachmodell und SPARQL als Wissensgrundlage vor. Neptune Database unterstützt RDF/SPARQL zur Speicherung und Abfrage; Inferenzanforderungen sind gesondert zu bewerten. Quellen zu den Datenbankfunktionen: GraphDB, Amazon Neptune FAQ.
Auch eccenca und TopQuadrant setzen auf semantische Standards. Welche Konstrukte und Funktionen im jeweiligen Produktpaket verfügbar sind, muss konkret geprüft werden. Quellen: eccenca Corporate Memory, TQ Data Foundation.
Ein OWL-Modell zu speichern ist etwas anderes, als die darin beschriebenen Schlussfolgerungen auszuführen. Die Unterstützung derselben Standards bedeutet deshalb kein identisches Inferenzverhalten. Maßgeblich sind die Konstrukte, Abfragen und Regeln der Anwendung.
Lassen sich bestehende Stardog-Ontologien und Mappings weiterverwenden?
RDF-basierte Ontologien und SPARQL-Abfragen sind wiederverwendbar, soweit die Zielplattform ihre Konstrukte und Abhängigkeiten unterstützt. Identifikatoren müssen erhalten bleiben. Anschließend sind erwartete Abfrageergebnisse und Inferenzverhalten zu testen.
Quellmappings benötigen eine eigene Kompatibilitätsprüfung. Stardog unterstützt R2RML und SMS2; die Werkzeuge können Mappings in unterstützten Fällen übersetzen. Eigene Ausdrücke, nichtrelationale Mappings und laufzeitspezifische Funktionen können Anpassungen erfordern. Repräsentative Beispiele zeigen, was direkt übertragbar ist. Quellen: Virtual Graphs, Mapping-Tutorial.
Sollte ein Unternehmen Stardog ersetzen oder ergänzen?
Eine Ablösung ist sinnvoll, wenn die Zielplattform die erforderlichen Aufgaben übernimmt und der Nutzen die Migration rechtfertigt. Eine Ergänzung kommt infrage, wenn bestehende Graphdienste weiterhin gebraucht werden und eine zusätzliche Komponente nachweislich Mehrwert bietet, etwa eine andere Kontextbereitstellung.
In beiden Fällen müssen Definitionen, Mappings, Berechtigungen und Aktualisierungen klare Verantwortliche haben. Der Test sollte mit einem Fachbereich beginnen. Eine Kombination aus d.AP und Stardog erfordert Integrationsplanung und Validierung; eine fertige Verbindung darf nicht vorausgesetzt werden.
Was ist bei einer Knowledge-Graph-Plattform für KI-Agenten zu prüfen?
Entscheidend ist der gesamte Ablauf von der Fachfrage bis zur Antwort. Welche Begriffe und Beziehungen werden ausgewählt? Liefert die Abfrage die richtigen Fakten? Wie behandelt der Agent Mehrdeutigkeit und Zugriffsrechte?
Die Prüfung sollte fachbereichsübergreifende Fragen, veränderte Quelldaten und unvollständige Informationen umfassen. Kontextabdeckung und Antwortkorrektheit sind getrennt von Latenz und Graphgröße zu messen. Hinzu kommen der Pflegeaufwand für Fachdefinitionen und die Wiederverwendbarkeit der Wissensmodelle außerhalb der Plattform.
Fazit: Die Stardog-Alternative nach der Aufgabe auswählen
RDF-Inferenz, semantische Governance, Datenvirtualisierung, Graphanalysen und KI-Kontext benötigen unterschiedliche Tests. Die Auswahl sollte an der Funktion ansetzen, die verbessert werden soll.
Für Agentenkontext gehört d.AP in die engere Auswahl, wenn ontologiegestützte Kontextzusammenstellung wichtig ist. Das gilt insbesondere bei großen oder komplexen Wissensmodellen. Der Vergleich muss Stardogs aktuelle semantische Funktionen und KI-Fähigkeiten berücksichtigen. Verlangt werden sollten Nachweise für vollständigen Kontext, korrekte Abfragen, belegte Antworten, eingehaltene Rechte und Betriebskosten.
d.AP mit den eigenen Anforderungen vergleichen: Ein Gespräch mit digetiers kann bei einer repräsentativen Ontologie, konkreten Fachfragen und den Grenzen der bestehenden Architektur ansetzen. Daraus entsteht ein messbarer Vergleich, bevor über eine Ablösung entschieden wird. Kontakt zu digetiers